Что пишут в блогах
- Практическое руководство по тестированию миграции цифровой инфраструктуры
- Тестирование без требований: как навести порядок в QA за 90 дней
- Про неочевидные аспекты менторства
- QA-практики, которые работают даже на проектах без четких требований и ТЗ
- О менторах, о дружбанах, о древнегреках
- Тестирование без требований: оракулы, карта продукта и риск-ориентированный подход
- Курс автоматизации в Postman полностью обновлен!
- Осторожно, пираты! (бумажные книги на озоне)
- Синтетические данные для тестирования: практика, типичные ошибки и экономика внедрения
- А я тебе говорю, оно работает! (ИИ косячит)
Что пишут в блогах (EN)
- My learning bits for Saturday of 24th October 2026
- My learning bits for Friday of 23rd October 2026
- My learning bits for Thursday of 22nd October 2026
- Main 3k Character Syndrome
- My learning bits for Wednesday of 21st October 2026
- My learning bits for Tuesday of 20th October 2026
- Ideation and oracles - where AI does better than testers
- When the Whistle Blows – An Ethics Experience Report
- My learning bits for Sunday of 18th October 2026
- My learning bits for Friday of 16th October 2026
Онлайн-тренинги
-
Charles Proxy как инструмент тестировщикаНачало: 29 октября 2026
-
Школа для начинающих тестировщиковНачало: 29 октября 2026
-
CSS и Xpath: инструменты тестировщикаНачало: 29 октября 2026
-
Азбука ИТНачало: 29 октября 2026
-
Git: инструменты тестировщикаНачало: 29 октября 2026
-
Регулярные выражения в тестированииНачало: 29 октября 2026
-
Chrome DevTools: Инструменты тестировщикаНачало: 29 октября 2026
-
Тестирование GraphQL APIНачало: 29 октября 2026
-
SQL: Инструменты тестировщикаНачало: 29 октября 2026
-
Bash: инструменты тестировщикаНачало: 29 октября 2026
-
Docker: инструменты тестировщикаНачало: 29 октября 2026
-
Автоматизация функционального тестированияНачало: 30 октября 2026
-
Тестирование REST APIНачало: 2 ноября 2026
-
Автоматизация тестов для REST API при помощи PostmanНачало: 5 ноября 2026
-
Инженер по тестированию программного обеспеченияНачало: 5 ноября 2026
-
Применение ChatGPT в тестированииНачало: 5 ноября 2026
-
Создание и управление командой тестированияНачало: 5 ноября 2026
-
Тестирование веб-приложений 2.0Начало: 6 ноября 2026
-
Организация автоматизированного тестированияНачало: 6 ноября 2026
-
Тестирование без требований: выявление и восстановление информации о продуктеНачало: 9 ноября 2026
-
Логи как инструмент тестировщикаНачало: 9 ноября 2026
-
Автоматизация тестирования REST API на JavaНачало: 11 ноября 2026
-
Автоматизация тестирования REST API на PythonНачало: 11 ноября 2026
-
Тестирование безопасностиНачало: 11 ноября 2026
-
Тестирование мобильных приложений 2.0Начало: 11 ноября 2026
-
Программирование на C# для тестировщиковНачало: 13 ноября 2026
-
Тестировщик ПО: интенсивный курс (ПОИНТ) со стажировкойНачало: 17 ноября 2026
-
Школа тест-менеджеров v. 2.0Начало: 18 ноября 2026
-
Практикум по тест-дизайну 2.0Начало: 20 ноября 2026
-
Тестирование производительности: JMeter 5Начало: 20 ноября 2026
-
Техники локализации плавающих дефектовНачало: 23 ноября 2026
-
Школа Тест-АналитикаНачало: 25 ноября 2026
-
Программирование на Java для тестировщиковНачало: 27 ноября 2026
-
Программирование на Python для тестировщиковНачало: 27 ноября 2026
-
Аудит и оптимизация процессов тестированияНачало: 4 декабря 2026
| Укрощаем зоопарк, или Тестируем с помощью собственных API-mocks |
| 28.10.2026 00:00 |
|
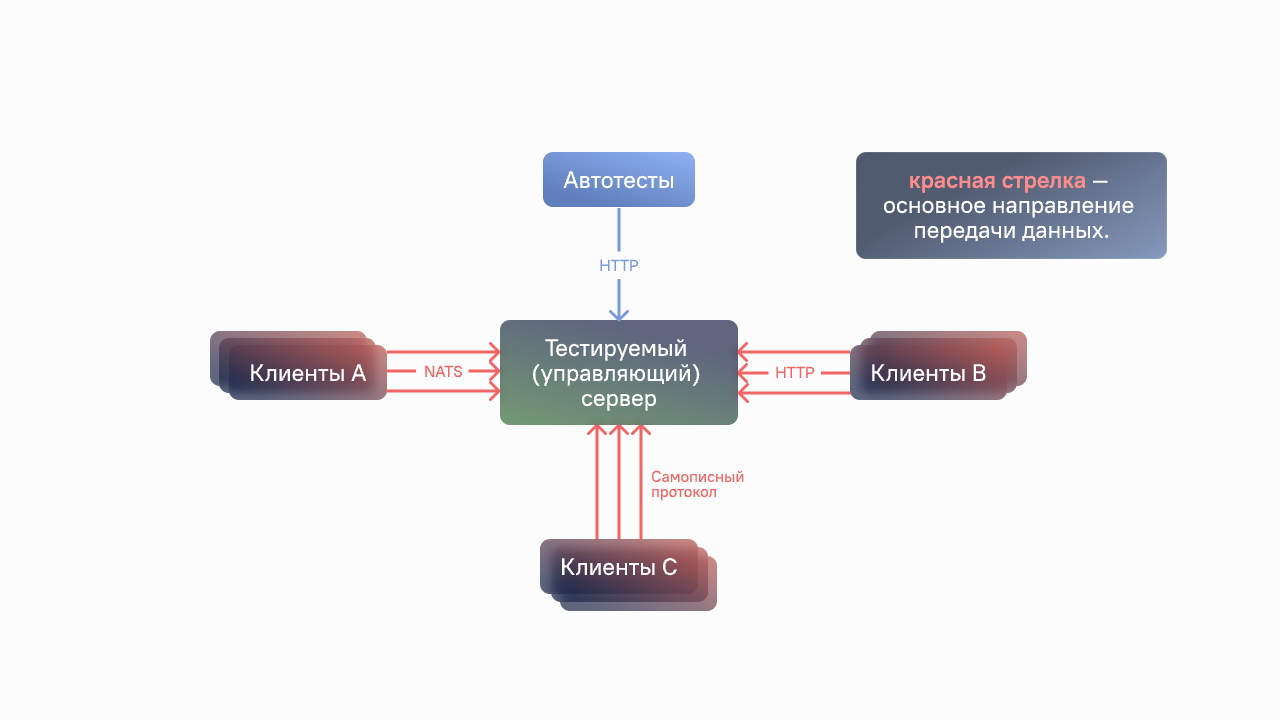
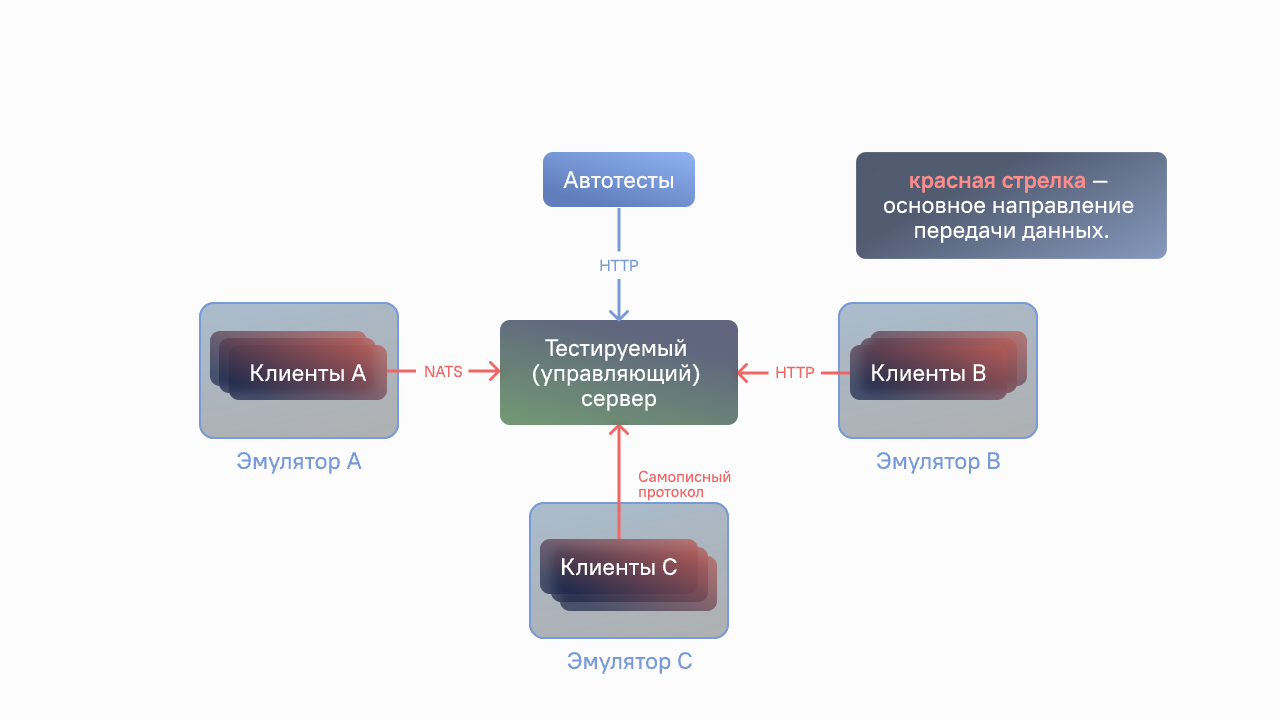
Статья из блога компании ИнфоТеКС Tech Как тестировать систему, если половина её компонентов — это «чёрные ящики» с уникальными протоколами, а стандартные API-mocks не справляются? С точки зрения готовых решений — тупик… Меня зовут Дмитрий, я AQA-инженер в ИнфоТеКС. Мы с командой столкнулись с этой проблемой и создали собственные API-mocks, которые не просто отвечают шаблонными сообщениями, а ведут себя как настоящие компоненты системы. В этой статье — наш путь от идеи до работающего решения, которое можно адаптировать под ваши задачи. Содержание Что мы тестировали?Продукт представляет собой сервер с веб-интерфейсом. Он управляет множеством клиентских устройств, подключающихся к нему по HTTP, NATS и самописным протоколам. Все эти протоколы, кроме HTTP, поддерживают двунаправленную связь, то есть не только клиенты могут отправлять запросы к управляющему серверу, но и сервер может отправлять данные клиентским устройствам.
Клиенты (A, B, C на схеме выше) могут иметь разные исполнения: виртуальная машина или программно-аппаратные комплексы (ПАК) с разными конфигурациями аппаратного обеспечения. Ближайшая аналогия — интернет вещей (IoT), где, например, умная колонка выступает в качестве управляющего устройства, к которому подключаются разнообразные устройства и датчики. Ограниченность существующего подходаЧасто основное тестирование в проекте — ручное, а автотесты покрывают лишь небольшую часть веб-интерфейса, юнит-тестов немного. При выпуске первых релизов такой подход может себя оправдывать, но с развитием продукта неизбежно встаёт вопрос о проведении нагрузочного тестирования. Обычно нагрузочное тестирование HTTP-сервера заключается в генерировании трафика от определённого количества пользователей. В нашем случае пользователи исчислялись единицами, а вот их устройства — сотнями.
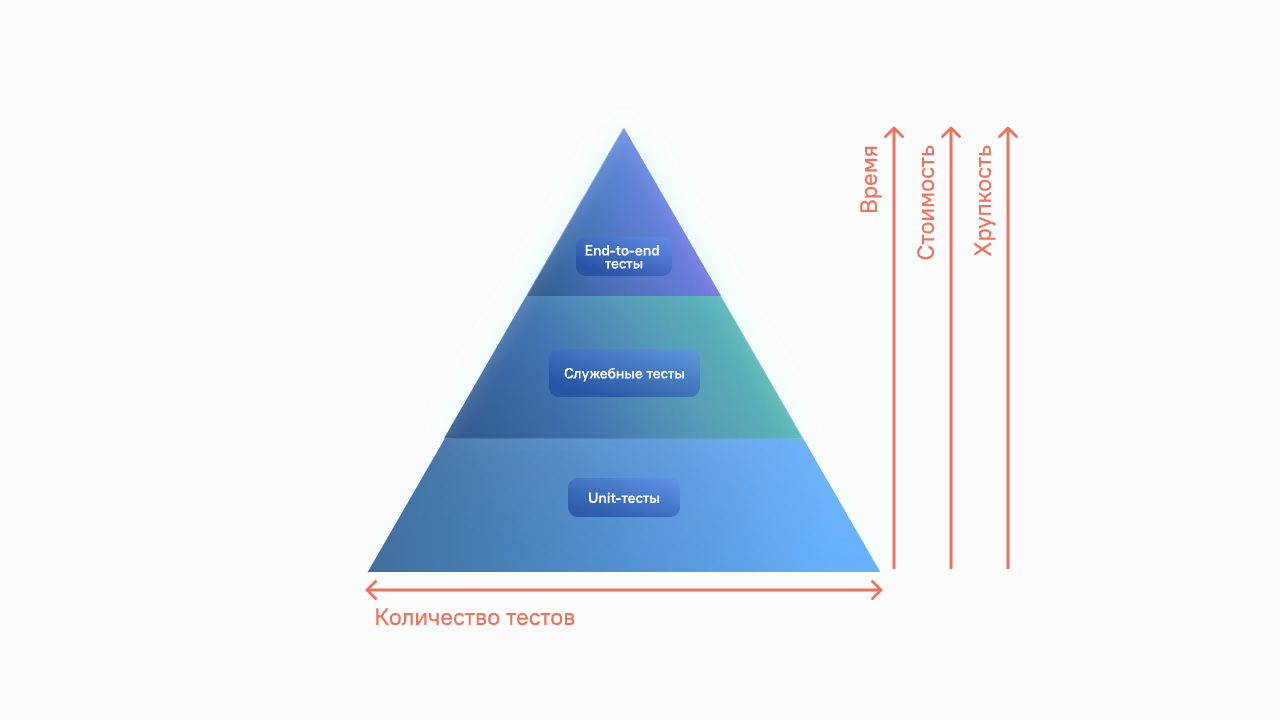
Проще всего, конечно, решить проблему «в лоб» и купить несколько сотен hardware-серверов разных типов клиентских устройств или развернуть столько же виртуальных исполнений на гипервизоре. Но, разумеется, это было бы чрезмерно дорого. Поиск решенияВ основании классической пирамиды тестирования находятся юнит-тесты как самый стабильный и многочисленный класс автотестов. Чуть выше располагаются служебные тесты, которые уже не проверяют отдельные модули или сервисы приложения, как юнит-тесты, а нацелены на тестирование взаимодействия между ними (например, взаимодействие backend с базой данных). На верхушке пирамиды располагаются end-to-end тесты, самые трудоёмкие и нестабильные, но при этом максимально приближенные к действиям пользователя.
Если попробовать применить данную концепцию к нашему примеру, то можно заметить, что у нас полностью отсутствовал класс служебных тестов. Самой перспективной идеей для реализации этих тестов была изоляция тестируемого сервера от всех клиентских устройств и замена их специальными mocks. В таком случае тестировщик получает полный контроль над всеми присылаемыми на сервер данными, что позволяет полностью протестировать API. Большинство существующих решений (Postman, Mockoon, WireMock, Apidog) нацелены на построение только HTTP-серверов с заранее заданными статичными ответами на запросы. Но хотелось найти единое решение, которое поддерживало бы всё разнообразие протоколов и позволяло динамически генерировать данные для отправки на сервер. Поэтому мы решили самостоятельно реализовать API-mocks (далее — эмуляторы), так как они эмулируют работу реальных устройств. Первые шагиВ качестве основного стека технологий выбрали Python и Flask из-за простоты использования и высокой скорости разработки. Интерпретируемость Python позволяет быстро редактировать исходный код и легко менять данные, используемые им (в нашем случае, данные запросов эмуляторов). Главное требование к эмуляторам — масштабируемость, то есть возможность создавать несколько экземпляров одного типа устройства на одном эмуляторе. Это позволило решить проблему подключения нескольких сотен устройств одного типа к тестируемому серверу.
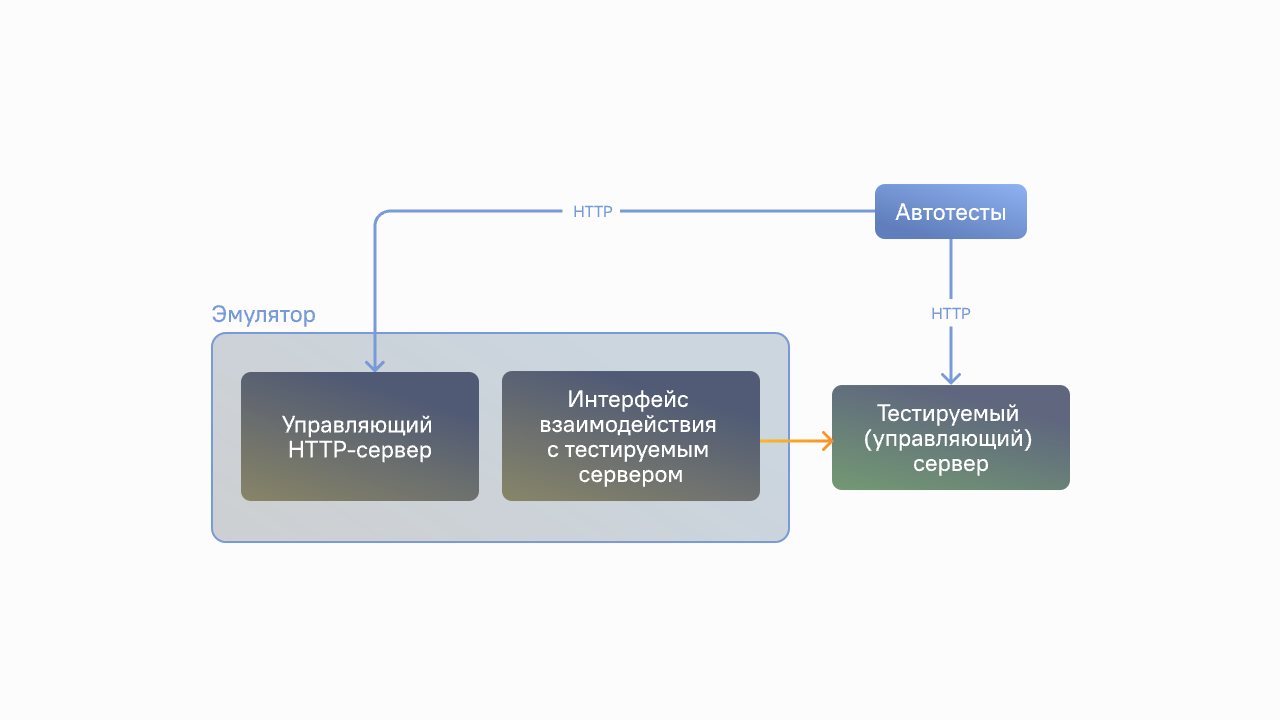
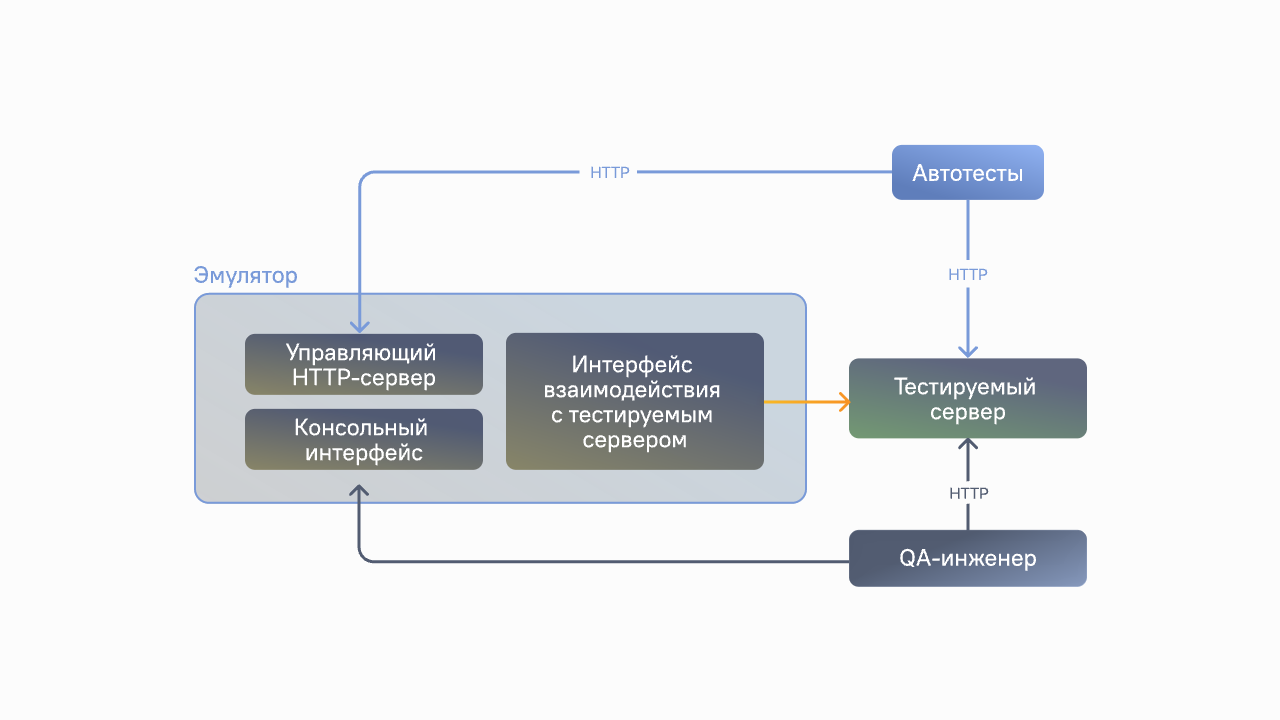
Каждый эмулятор поддерживал функции клиента только одного типа, в нашем случае подобных эмуляторов оказалось три (клиенты А, В и С). На этом этапе они представляли собой простую систему, состоящую из двух частей:
Эмулятор никак не обрабатывал и не сохранял информацию, поступающую от тестируемого сервера, и возвращал одни и те же ответы на запросы. Ниже представлена схема тестового стенда с использованием эмуляторов. Итоговая реализацияПосле первых использований эмуляторов было решено добавить дополнительные функции, которые значительно упростили процесс работы и повысил их полезность. О них далее. Динамические данныеВместо статических ответов на эмуляторах мы реализовали часть логики реальных устройств: теперь эмуляторы запоминают входящие данные, на их основе могут формировать ответы на дальнейшие запросы, а также менять собственное состояние. Это значительно расширило применение эмуляторов и позволило использовать в более сложных сценариях. Docker-контейнерЕщё одним улучшением стало размещение эмуляторов в Docker-контейнерах и поставка их в таком виде другим членам команды, а именно QA-инженерам и backend-разработчикам. Теперь им не нужно узнавать у разработчика эмулятора ветку, в которой следует запускать эмулятор, или список новых библиотек, необходимых для работы новой версии эмулятора. Достаточно знать тег актуального Docker-образа.
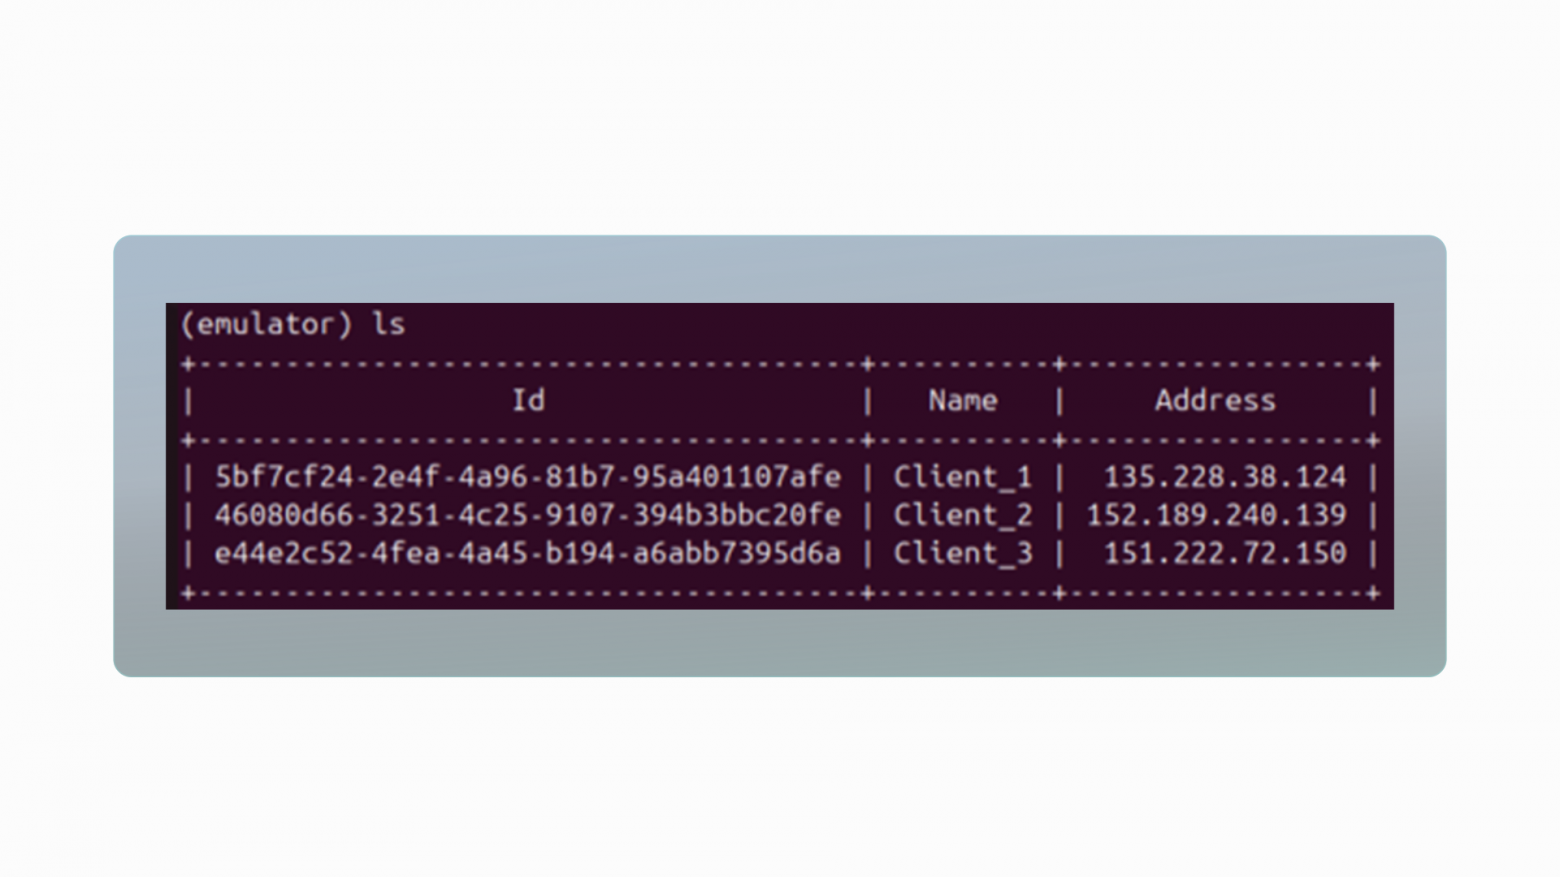
Режим работыСамое полезное усовершенствование — реализация двух режимов работы эмуляторов: консольного и серверного. Режим выбирается при запуске. Консольный режимЭмуляторы оказались полезны не только в автотестах, но и в ручном тестировании, так как позволили QA-инженерам быстрее и проще настраивать тестовые стенды для специфических сценариев. Для большего удобства реализовали консольный интерфейс: он позволяет пользователю управлять работой эмулятора через командную оболочку, которая была реализована с помощью фреймворка Cmd стандартной библиотеки Python. Команды в консольном режиме
Серверный режимСерверный режим изменился в двух аспектах, добавились:
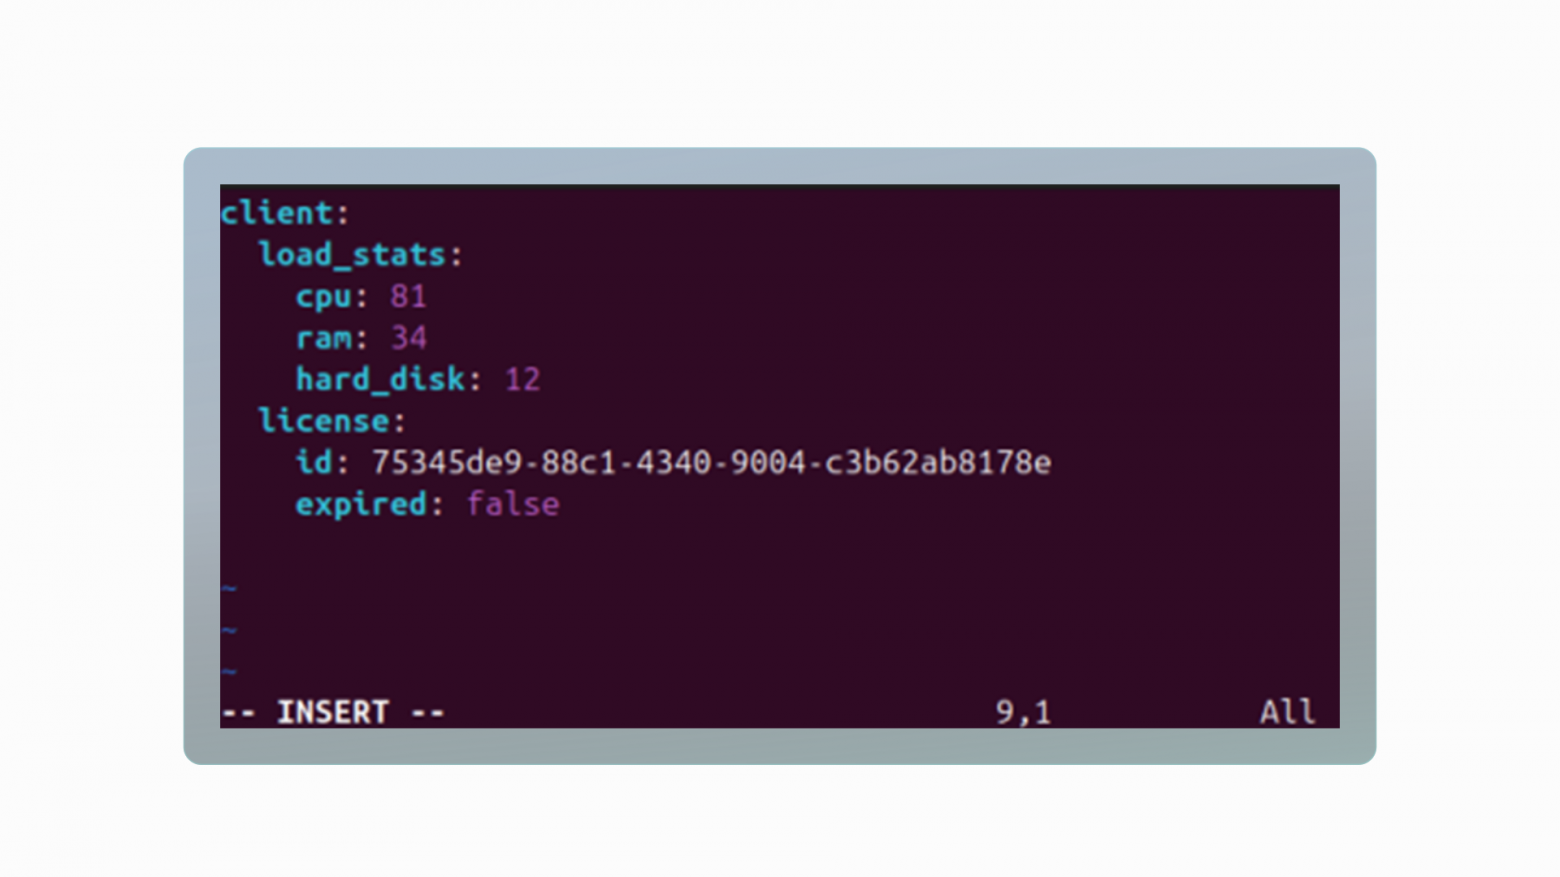
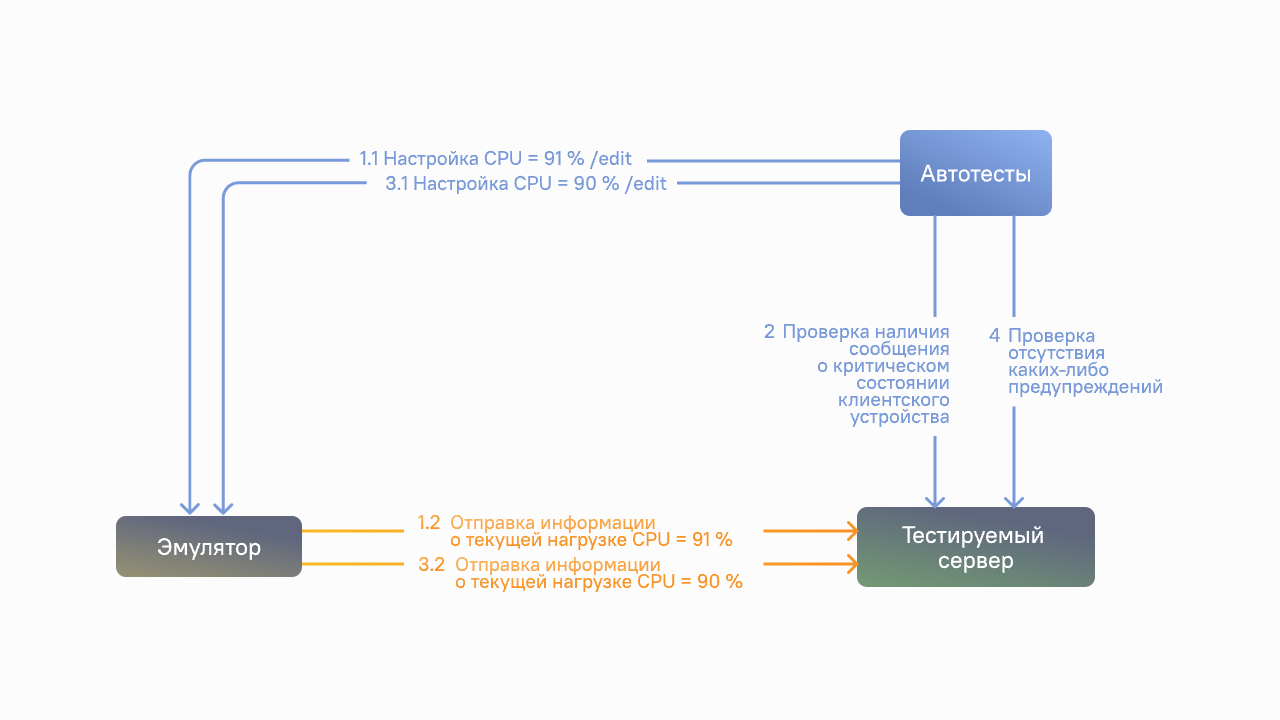
Серверный режим всё так же предназначен для использования совместно с автотестами и нагрузочными скриптами. Итоговая схема работы эмулятораПример использования эмулятораРассмотрим следующий пример, когда удобно использовать эмулятор. Представим, что тестируемый сервер принимает информацию о нагрузке на CPU (%) от клиентских устройств и должен показать уведомление пользователю, если это значение на одном из клиентских устройств превышает 90%. На основании этой информации составили следующий тестовый сценарий:
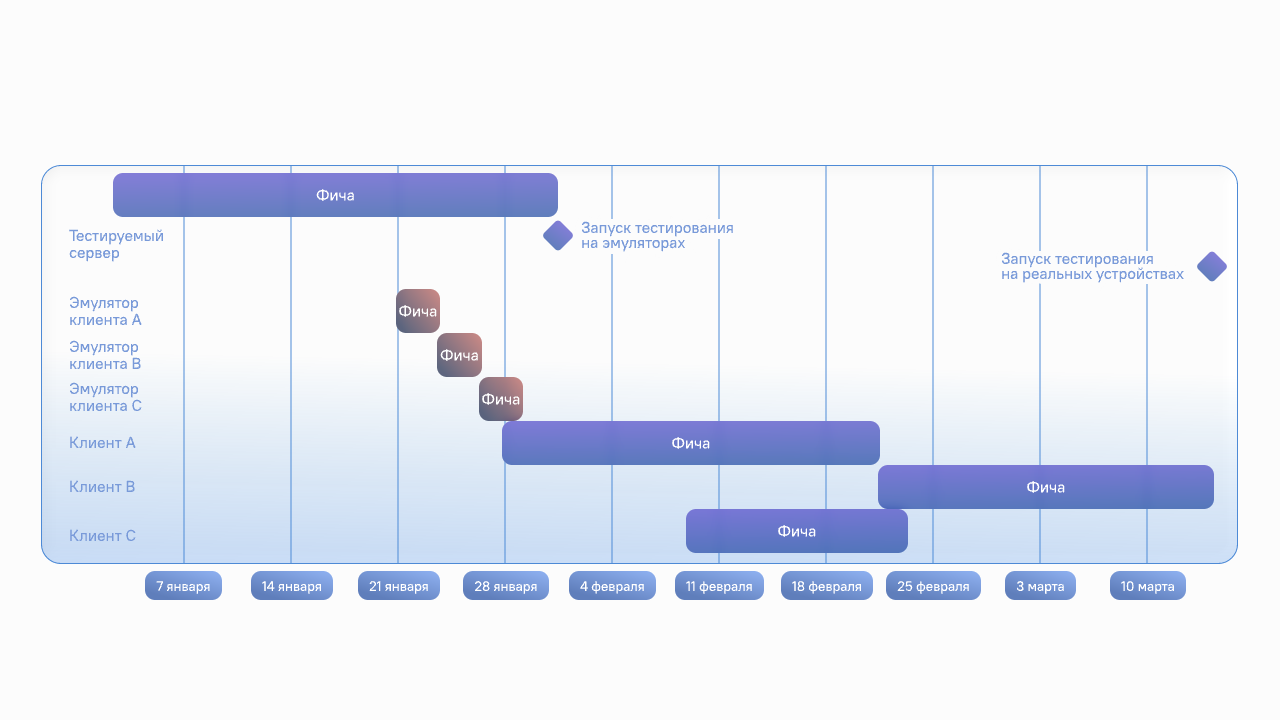
Использование эмулятора упрощает подготовку перед выполнением стенда, так как в реальных условиях смоделировать ситуацию, когда на клиентском устройстве будет определённая нагрузка на CPU с точностью до одного процента, очень сложно. Эмулятор же позволяет изменить состояние устройства с помощью одной команды или HTTP-запроса. При этом добиться проверки необходимых комбинаций работы API между сервером и клиентом, как при тестировании на реальных устройствах. Преимущества использования собственных API-mocksНезависимость тестированияМожно тестировать интеграционные фичи до их реализации на других продуктах и предоставлять стабильную сборку сервера смежным командам, чтобы они могли отладить свои клиентские устройства. Ниже на диаграмме Ганта показана ситуация, когда команды разных продуктов разрабатывают интеграционные фичи независимо друг от друга.
Новая функциональность внедряется в эмуляторы, когда завершается её реализация на управляющем сервере, что позволяет сразу же приступить к тестированию (конец января на диаграмме). Тестирование на реальных устройствах может начаться лишь только после завершения разработки на всех устройствах спустя продолжительное время (в середине марта на диаграмме). Простота масштабированияКаждый эмулятор позволяет создавать несколько экземпляров устройств одного типа — это упрощает проведение и кастомизацию сценариев нагрузочного тестирования. МногофункциональностьВ консольном режиме эмуляторы можно использовать не только в автоматизации (автотесты и нагрузка), но и в эксплоративном тестировании QA-инженерами. Ускорение тестированияС помощью эмуляторов можно проверить сложные и длительные сценарии значительно быстрее. Такая возможность появилась благодаря упрощению и ускорению настройки стенда перед прохождением теста. Недостатки использования собственных API-mocksСложность поддержкиОсновной недостаток — поддержка эмуляторов полностью ложится на команды тестирования. Чтобы QA-инженеры могли ими воспользоваться при тестировании, при выпуске новых фичей в продукте приходится сразу поддерживать их и на эмуляторе. Необходимость end-to-end тестовНе все баги могут быть найдены при использовании эмуляторов, так как часть из них зависит только от внутренней реализации реальных продуктов. Именно поэтому подобный подход в тестировании должен лишь дополнять end-to-end тесты с реальными устройствами, а никак не заменять их. ЗаключениеТестирование сложных распределённых систем больше не должно превращаться в борьбу с ограничениями готовых решений.
Конечно, подход не идеален: поддержка эмуляторов требует ресурсов, а end-to-end тесты с реальными устройствами всё равно необходимы. Но когда нужно быстро проверить логику, не дожидаясь готовности всех компонентов — это мощный инструмент в арсенале QA-инженеров и разработчиков. А как вы решаете проблему тестирования в условиях зоопарка протоколов? Делитесь опытом в комментариях — обсудим лучшие практики! |