Что пишут в блогах
- О менторах, о дружбанах, о древнегреках
- Тестирование без требований: оракулы, карта продукта и риск-ориентированный подход
- Курс автоматизации в Postman полностью обновлен!
- Осторожно, пираты! (бумажные книги на озоне)
- Синтетические данные для тестирования: практика, типичные ошибки и экономика внедрения
- А я тебе говорю, оно работает! (ИИ косячит)
- 7 шагов к конвейеру синтетических данных для тестирования
- Синтетические данные для тестирования: методология, масштаб и контроль приватности
- Юзабилити-аудит для B2B-сайта франшизы: от красивых кнопок к соответствию ожиданиям пользователей
- Покажите мне Playwright «с нуля»
Что пишут в блогах (EN)
- CAST 2026: "Accessibility, Automated Testing and AI - A Reality Check" with Chad Hester
- Hello From Cocoa Beach: CAST 2026 is Underway: "How Avoiding Conflict Is Breaking Your Team"
- Flooding the Zone, or Why Cheap Output Isn’t Free
- Testing A Product You (Personally) Love
- Who Is Actually Making the Architectural Decisions Right Now? Facilitating Architecture in an AI-Accelerated World
- The AI House presented by KPMG
- Humans In The Way
- Checking Isn’t Testing. Soon It Won’t Be Employment Either
- Measuring for AI success and quality improvement
- BSides Luxembourg 2026 - True Community Spirit
Онлайн-тренинги
-
Инженер по тестированию программного обеспеченияНачало: 8 октября 2026
-
Применение ChatGPT в тестированииНачало: 8 октября 2026
-
Азбука ИТНачало: 8 октября 2026
-
Аудит и оптимизация процессов тестированияНачало: 9 октября 2026
-
Программирование на C# для тестировщиковНачало: 9 октября 2026
-
Тестирование безопасностиНачало: 14 октября 2026
-
Автоматизация тестирования REST API на JavaНачало: 14 октября 2026
-
Автоматизация тестирования REST API на PythonНачало: 14 октября 2026
-
Школа тест-менеджеров v. 2.0Начало: 14 октября 2026
-
Тестирование мобильных приложений 2.0Начало: 14 октября 2026
-
Школа для начинающих тестировщиковНачало: 15 октября 2026
-
Автоматизация тестов для REST API при помощи PostmanНачало: 15 октября 2026
-
Программирование на Python для тестировщиковНачало: 16 октября 2026
-
Тестирование REST APIНачало: 19 октября 2026
-
Логи как инструмент тестировщикаНачало: 19 октября 2026
-
Тестировщик ПО: интенсивный курс (ПОИНТ) со стажировкойНачало: 20 октября 2026
-
Школа Тест-АналитикаНачало: 21 октября 2026
-
Программирование на Java для тестировщиковНачало: 23 октября 2026
-
Тестирование производительности: JMeter 5Начало: 23 октября 2026
-
Практикум по тест-дизайну 2.0Начало: 23 октября 2026
-
Техники локализации плавающих дефектовНачало: 26 октября 2026
-
Bash: инструменты тестировщикаНачало: 29 октября 2026
-
Charles Proxy как инструмент тестировщикаНачало: 29 октября 2026
-
Chrome DevTools: Инструменты тестировщикаНачало: 29 октября 2026
-
CSS и Xpath: инструменты тестировщикаНачало: 29 октября 2026
-
Docker: инструменты тестировщикаНачало: 29 октября 2026
-
SQL: Инструменты тестировщикаНачало: 29 октября 2026
-
Git: инструменты тестировщикаНачало: 29 октября 2026
-
Регулярные выражения в тестированииНачало: 29 октября 2026
-
Тестирование GraphQL APIНачало: 29 октября 2026
-
Автоматизация функционального тестированияНачало: 30 октября 2026
-
Создание и управление командой тестированияНачало: 5 ноября 2026
-
Организация автоматизированного тестированияНачало: 6 ноября 2026
-
Тестирование веб-приложений 2.0Начало: 6 ноября 2026
-
Тестирование без требований: выявление и восстановление информации о продуктеНачало: 9 ноября 2026
| Как мы приручили JMX-файл на 50 000 строк: декомпозиция JMeter-тестов для нормального code review |
| 07.10.2026 00:00 |
|
Автор: Макарий Петров
Работая в Сбере, я столкнулся с тем, что общепринятым инструментом для функционального тестирования в моем трайбе был JMeter. Нравится ли мне это? Вопрос второстепенный. Приходилось работать с тем, что есть. По мере того как разрастались наши компоненты и их функциональность - разрастались и JMeter-тесты. Если кто не сталкивался - вся логика JMeter-тестов описана в файле с расширением
Давайте для начала немного раскрою проблему. Что же плохого в файле на 50 000 строк?
Результат в числах
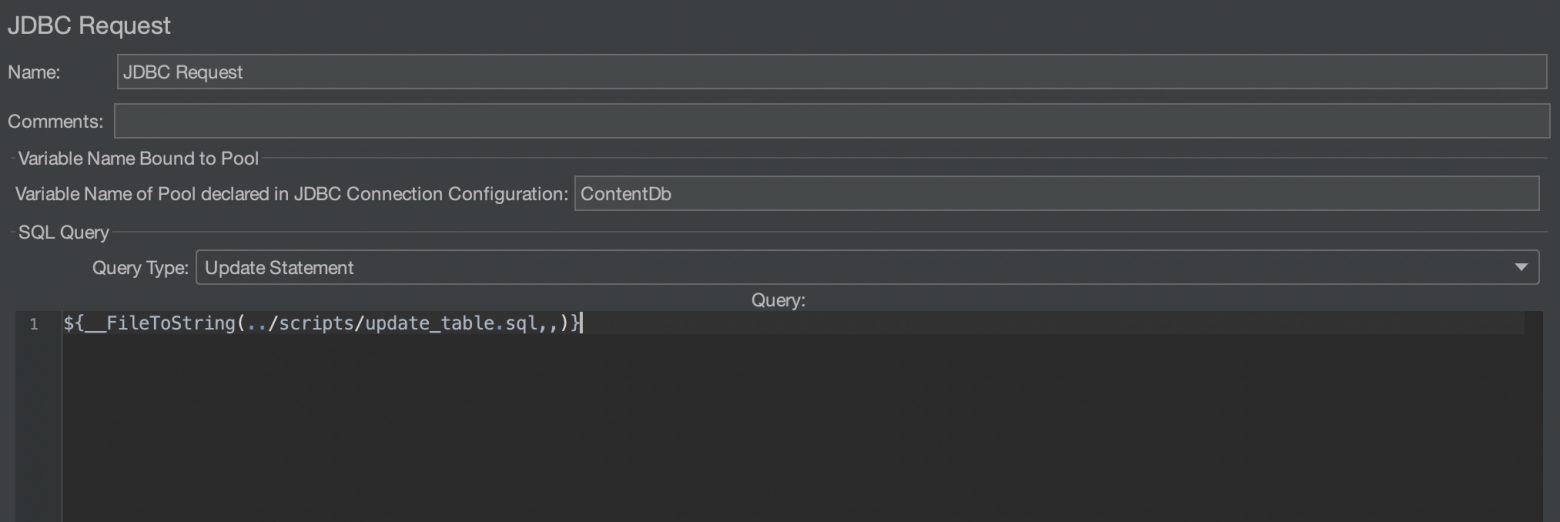
А теперь давайте поговорим о способах правильно структурировать JMeter-тесты, чтобы добиться такого же результата. Что делать с SQL-скриптами?Иногда для тестирования функциональности требуется подготовить таблицы в БД: добавить сущности, которые необходимы для тестов. Для этого в JMeter есть специальная нода - JDBC Request. И у неё есть некоторые минусы:
В идеале нам хотелось бы вынести эти SQL-скрипты в отдельные
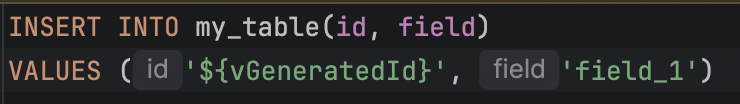
Однако у этой функции есть одна проблема - она не раскрывает автоматически переменные JMeter из
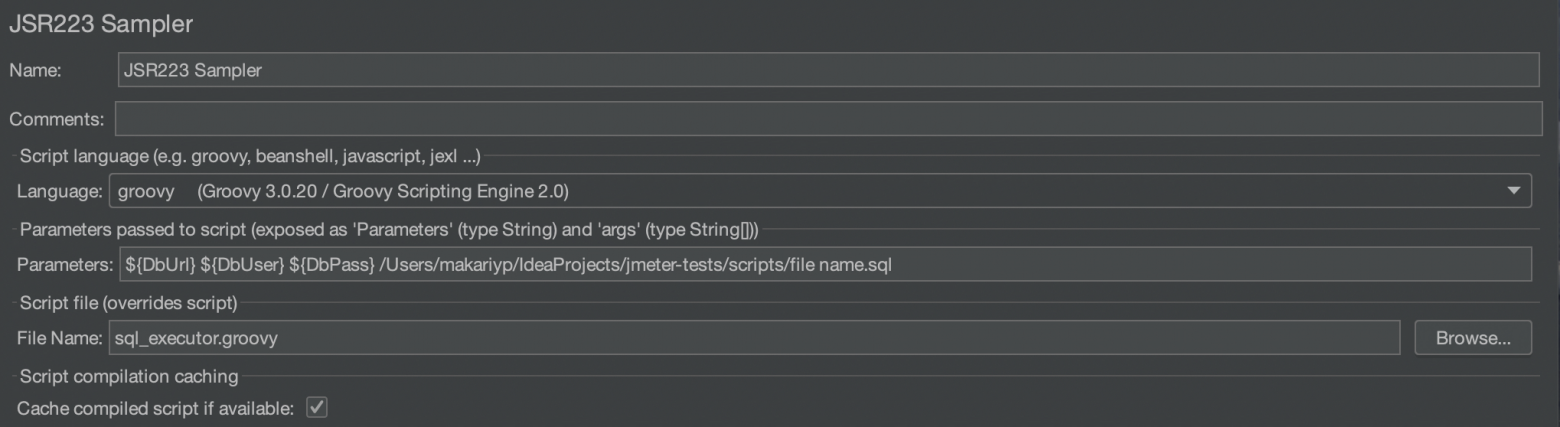
То теперь не можем, и переменная Было решено написать собственный скрипт, который автоматически раскрывал бы переменные, и нам не пришлось бы переписывать все SQL-запросы. Вот сам скрипт: А использовать его можно вот таким образом: нам понадобится нода JSR223 Sampler, в параметры которой мы передаём URL подключения к БД, логин, пароль и относительный путь до
На этом вынос SQL в отдельные файлы завершён. Вынос Groovy-скриптов из JSR223-элементовДанный пункт достаточно очевиден, но хотелось бы его подсветить. Все ноды, которые начинаются с Важный момент: при использовании внешних скриптов обязательно ставьте галочку «Cache compiled script if available» в настройках JSR223-элемента. Без неё JMeter будет перекомпилировать Groovy-скрипт при каждом вызове, что заметно просадит производительность. Также, если JMeter-тестов несколько, то общие утилиты на Groovy можно вынести в отдельные файлы. Например, скрипт по запуску SQL-скриптов, указанный выше, лежит в папке Разделение Thread Group по разным JMX-файламОказывается, кусочки JMX-файла можно вынести в разные файлы, указав на них ссылки в главном JMX. Как это делается? Конкретно в моём проекте тестирование каждого домена было вынесено в отдельный Thread Group. Достаточно было выделить всё, что вложено в каждый Thread Group, и нажать ПКМ → Save as Test Fragment, выбрав путь, где будет лежать логика этой Thread Group. Внедрение внешнего Test Fragment из JMX-файла делается с помощью ноды Include Controller. Подводные камни Include Controller:Будьте внимательны с путями. В GUI всё работает отлично, но при запуске из командной строки ( Итоговая структура проектаБыло: Стало: Каждая папка домена - самодостаточная единица. Открыл папку - сразу видишь и фрагмент теста, и все скрипты, которые к нему относятся. Что в итоге?Получилась архитектура, которая интуитивно понятна разработчикам, привыкшим к обычным проектам. Её легко ревьюить и поддерживать. А размер основного JMX-файла уменьшился в 10 раз. Основная идея моей концепции: в JMX-файлах хранится только порядок выполнения тестов. Вся остальная логика и проверки выносятся в отдельные файлы с необходимыми расширениями, и работа с ними ведётся из IDE со всеми её плюсами. |