Что пишут в блогах
- Юзабилити-аудит для B2B-сайта франшизы: от красивых кнопок к соответствию ожиданиям пользователей
- Покажите мне Playwright «с нуля»
- Как тестировать RAG-системы: методы, инструменты и метрики
- Что тормозит QA-процесс: ищем проблемы с помощью Lean, Six Sigma и Кайдзен
- Как мне ИИ помог в Redash разобраться
- ИИ в тестировании: ускорение проверки калькулятора с 3 недель до 3 дней
- Кейс о вайбкодинге корпоративной системы и её тестировании
- Курсор, куда ты лезешь? Эх, не прокатило...
- Почему реклама не приносит заявки: QA-основы, которые должен понять каждый маркетолог
- QAOps: как объединить QA и DevOps, чтобы ускорить релизы без потери качества
Что пишут в блогах (EN)
- CAST 2026: "Accessibility, Automated Testing and AI - A Reality Check" with Chad Hester
- Hello From Cocoa Beach: CAST 2026 is Underway: "How Avoiding Conflict Is Breaking Your Team"
- Flooding the Zone, or Why Cheap Output Isn’t Free
- The AI House presented by KPMG
- Humans In The Way
- Checking Isn’t Testing. Soon It Won’t Be Employment Either
- Measuring for AI success and quality improvement
- BSides Luxembourg 2026 - True Community Spirit
- Growing trees, today
- MCA Awards 2026
Онлайн-тренинги
-
Автоматизация тестирования REST API на PythonНачало: 16 сентября 2026
-
Тестирование мобильных приложений 2.0Начало: 16 сентября 2026
-
Автоматизация тестирования REST API на JavaНачало: 16 сентября 2026
-
Тестирование безопасностиНачало: 16 сентября 2026
-
Python для начинающихНачало: 17 сентября 2026
-
Азбука ИТНачало: 17 сентября 2026
-
Школа для начинающих тестировщиковНачало: 17 сентября 2026
-
Создание и управление командой тестированияНачало: 17 сентября 2026
-
Практикум по тест-дизайну 2.0Начало: 18 сентября 2026
-
Программирование на Java для тестировщиковНачало: 18 сентября 2026
-
Тестирование REST APIНачало: 21 сентября 2026
-
Школа Тест-АналитикаНачало: 23 сентября 2026
-
Автоматизация тестов для REST API при помощи PostmanНачало: 24 сентября 2026
-
Инженер по тестированию программного обеспеченияНачало: 24 сентября 2026
-
Применение ChatGPT в тестированииНачало: 24 сентября 2026
-
Автоматизация функционального тестированияНачало: 25 сентября 2026
-
Техники локализации плавающих дефектовНачало: 28 сентября 2026
-
Логи как инструмент тестировщикаНачало: 28 сентября 2026
-
Bash: инструменты тестировщикаНачало: 1 октября 2026
-
Chrome DevTools: Инструменты тестировщикаНачало: 1 октября 2026
-
Git: инструменты тестировщикаНачало: 1 октября 2026
-
Docker: инструменты тестировщикаНачало: 1 октября 2026
-
Регулярные выражения в тестированииНачало: 1 октября 2026
-
SQL: Инструменты тестировщикаНачало: 1 октября 2026
-
Тестирование GraphQL APIНачало: 1 октября 2026
-
Charles Proxy как инструмент тестировщикаНачало: 1 октября 2026
-
CSS и Xpath: инструменты тестировщикаНачало: 1 октября 2026
-
Тестирование веб-приложений 2.0Начало: 2 октября 2026
-
Программирование на C# для тестировщиковНачало: 9 октября 2026
-
Аудит и оптимизация процессов тестированияНачало: 9 октября 2026
-
Школа тест-менеджеров v. 2.0Начало: 14 октября 2026
-
Программирование на Python для тестировщиковНачало: 16 октября 2026
-
Тестировщик ПО: интенсивный курс (ПОИНТ) со стажировкойНачало: 20 октября 2026
-
Тестирование производительности: JMeter 5Начало: 23 октября 2026
-
Организация автоматизированного тестированияНачало: 6 ноября 2026
-
Тестирование без требований: выявление и восстановление информации о продуктеНачало: 9 ноября 2026
| Что значит «отвечать за качество»? |
| 16.09.2026 00:00 | |||||||||||||||
|
Автор: Пономарева Анастасия Недавно знакомый PM попросил рассказать «Что значит отвечать за качество?» в контексте продуктовых команд. Вопрос оказался не из простых, ведь каждый проект имеет свои особенности. Да и понятие качества может отличаться. Ниже — мой взгляд на тему через призму измеримых показателей. Если у вас есть дополнения, другие метрики или иной управленческий опыт — велкам в комментарии. Будет интересно обсудить и расширить картину. Начну немного издалека. Последние лет пять тема продуктовых команд очень популярна. Тестировщиков из «колодцев» и подчинения QA лидам и хэдам забирают в команды. Если сначала было матричное управление с функциональным руководством, то последние годы растет тренд на отказ от QA лидов с передачей функции лидам продуктовых команд. Делается это по двум причинам:
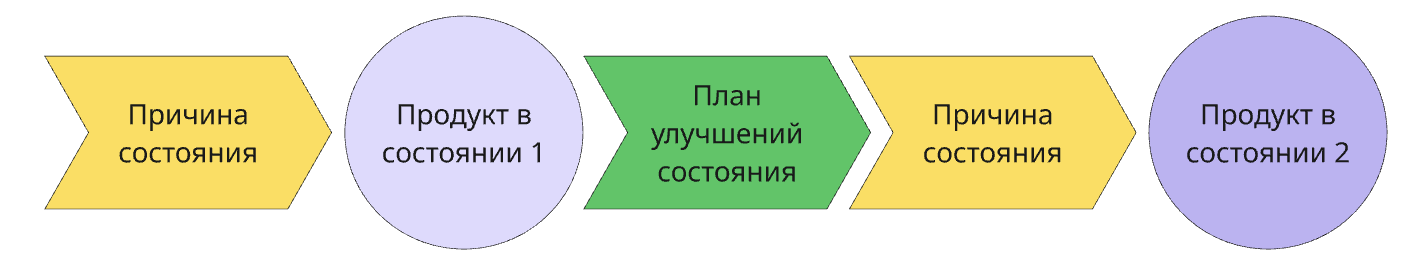
Так что в некотором смысле передать всю ответственность в одни руки — здраво. Другой вопрос, что не всегда понятно, в чем эта ответственность заключается и какие у нее границы. Ведь отвечать за качество — это не только управлять тестировщиками и следить за количеством багов. Это про владение всей системой качества на уровне команды: выстраивание процессов, прозрачность рисков, понимание текущего состояния продукта. Ответственный за качество должен в любой момент времени знать в каком состоянии находится продукт. Понимать, что привело его в такое состояние. И иметь план улучшения этого состояния.
Чтобы это стало возможным, необходимо разбираться в процессах. Знать, как устроена аналитика, как выстроена разработка, как организовано тестирование и что происходит с дефектами после релиза. Потому что состояние продукта — это следствие состояния процессов. И если процессы непрозрачны и нестабильны, качественный результат будет случайностью, а не закономерностью. Качество продуктаСостояние продукта это всегда про метрики. Набор может варьироваться, но есть двойка лидеров, применимых всегда. Продукт качественный когда:
Есть еще прекрасный показатель Net Promoter Score (NPS) или готовность пользователей рекомендовать продукт другим. Но измерить его могут не все. А если и могут, то не делают. А если и делают, то инженеры об этом не знают. Так что NPS к моему огромному сожалению, часто неприменим. Криты и блокеры в продеБлокирующий дефект — значит система не работает вообще и бизнес теряет деньги, так как клиенты не могут работать с продуктом. Собственно критерий сколько денег теряет бизнес и есть самый валидный показатель важности и срочности дефекта прода. Самое логичное — считать этот показатель. Если в вашей команде есть такая практика или хотя бы возможность ее внедрить — поздравляю! Степень зрелости ваших процессов очень высокая! Если нет — к этому нужно стремиться. Если возможности посчитать стоимость пропущенного дефекта нет, придется ориентироваться на severity и priority. Либо на что-то одно. И было бы очень здорово, чтобы все участники процесса, от бизнеса до поддержки, одинаково понимали что значит тот или иной уровень. Так что должно быть общепринятое, простое как палка и понятное трехлетке описание степеней критичности внутренних и внешних дефектов.
Критов и блокеров в проде быть не должно. А вот количество мажоров и остальных дефектов — метрика, которую необходимо рассчитывать опытным путем для каждой команды. И обязательно смотреть на соотношение внешних и внутренних дефектов по одному функционалу. Для этого есть показатель Defect Efficiency Rate (DER). DER = Dint / (Dint+Dext) * 100% где: Чем выше метрика, тем лучше. В среднем по больнице 80-90% дефектов должно быть обнаружено до выхода в прод (при условии, что у вас нет других договоренностей с бизнесом). Стабильность продукта 99,999%Напомню, количество девяток это показатель доступности системы — Availability. Если 99,999%, то в год продукт не работает что-то около 5 минут. Для обычного В2В достаточно трех девяток, то есть 99,9% (иногда бывает достаточно и 99,5%). В этом случае в год система недоступна ~8 часов. Availability = Uptime / Total Time * 100% где: Можно считать Downtime — это прямое измерение времени простоя. Обычно эти показатели считают SRE. Если у вас нет SRE или доступность конкретно вашей функциональности не считается — стоит над этим поработать, метрика важная. Но только считать не достаточно. Каждый дефект, который вызвал простой, необходимо разбирать и формулировать план действий, чтобы в будущем не повторилось. Процессы создания продуктаЧтобы управлять качеством продукта, необходимо держать под контролем сам способ его создания — то есть выстраивать систему процессных показателей. И первая процессная метрика, которую необходимо отслеживать это TTM (Time to Market). Она охватывает весь процесс: от зарождения идеи, когда инициатива только зафиксирована (roadmap/OKR/инвестиционное решение), до выхода в прод. Более простая альтернатива это Lead Time. Считается с момента, когда началась проработка задачи в команде. Lead Time классно работает в связке с Cycle Time (только активная работа, без ожиданий, заморозки и очередей). Чтобы отслеживать Cycle Time нужно очень трепетно следить за статусами задач, но зато и профит большой.
Time in Status (Stage Time) — для отслеживания времени на каждой стадии (Dev, QA, Review и т.д.). Позволяет выявлять узкие места. Можно использовать для облегчения подсчета Cycle Time, если ввести стадию “Hold”. Вот такой начальный набор. Чтобы все это считать, статусная модель жизни задачи должна соответствовать вашим целям. Ее не нужно бояться менять после выяснения новых узких мест.
Метрики показывают симптомы. А управлять нужно причинами. Чтобы влиять на TTM, Lead Time и предсказуемость результата, необходимо разбираться в том, как устроены ключевые процессы создания ценности: аналитика, разработка и тестирование. Рассмотрим их по отдельности. Качество тестированияЧтобы влиять на качество процесса тестирования, необходимо понимать, почему тестирование пропускает дефекты в прод. Конечно в пропуске виновато не только тестирование, но и вся команда, однако, тестирование — последняя стадия и разматывать причинно-следственную связь необходимо с нее. Причины пропуска дефектов в прод могут быть:
Эти причины только про тестирование, чтобы улучшать процесс. Анализ дефектов прода должен быть регулярным и не для формальной галочки, а с планом улучшений. Во внутренних дефектах следует отслеживать процент невалидных: “Дубликат”, “Не воспроизводится”, “Фича, а не бага” и пр. Показатель нужен, чтобы разработка не выполняла лишнюю работу и не тратила свое время на бесполезную активность. Каждый “Дубликат” это время тестировщика на заведение бага, время разработчика на то, чтобы разобраться о чем дефект и чтобы понять, что бага уже исправлена. В худшем случае — разработчик может пофиксить ее повторно. Этого можно избежать, потратив пару минут на проверку, нет ли уже такого дефекта. Следующий важный пункт — регресс. По умолчанию считаем, что он у вас есть и проводится на регулярной основе. Внимание стоит обращать на два показателя: длительность проведения и полнота. Отслеживать полноту лучше поручить тестировщикам и аналитикам, предварительно договорившись о механизмах добавления тестов в регрессионные сет. Почему так? Потому что численной метрикой тут часто не обойтись, а с глубоким погружением профильные специалисты справляются лучше. А вот длительность регресса — должна стать базовой метрикой. Если быстро растет — плохо, либо что-то лишнее, либо недоавтоматизировано. Если не растет — тоже плохо, возможно сломался процесс добавления тестов в регресс. На длительном промежутке времени длительность регресса — синусоида. Добавили тестов — время выросло. Провели рефакторинг, почистили, автоматизировали — и время стало меньше. Отдельно про автоматизациюАвтоматизация — не панацея. Перед тем как автоматизировать нужно считать ROI (Return on Investment) и учитывать не только время на разработку, но и последующую поддержку, среду для прогона и прочее и прочее. Чтобы не растекаться, примем, что автоматизация в вашем случае действительно несет пользу. Базовая метрика это процент автоматизированного функционала — Test Automation Coverage (TAC). Думаю тут и объяснять не надо зачем и почему. TAC = Fautomated / Ftotal * 100% где: Далее — Pass Rate, процент успешно завершенных автотестов от общего количества запущенных тестов. Считается для регресса. Pass Rate = Tpassed / Ttotal *100% где:
Еще одна важная метрика — сколько дефектов находят автотесты до продакшена. Это главный показатель их реальной пользы. Можно считать: Если автотесты баги почти не находят — значит автоматизировано не то или не там. В отличие от покрытия и количества тестов, эта метрика напрямую показывает ценность для бизнеса. И тут важно помнить, что если автоматизация не ускоряет релизы и не снижает риски — это не инвестиция в качество, а самообман за счет бюджета компании. Качество разработки и аналитикиОтвечать за качество, конечно, это не только про тестирование. Но так как тестирование — момент истины и финальный чек, то ухудшающиеся метрики тестирования могут говорить о проблемах на более ранних стадиях. О качестве разработки можно делать выводы, анализируя дефекты внутреннего тестирования. И вот на что тут полезно смотреть: Причина дефекта: аналитика или разработкаЕсли причина — разработка, значит ошибка допущена на этапе реализации: невнимательность, недопроверка, слабые unit-тесты или формальное ревью. Если причина — аналитика, значит реализация была корректной, но ошибка заложена в постановке. Такие дефекты дороже: ресурсы уже потрачены, а переделывать приходится все. Рост подобных случаев — повод пересмотреть качество требований и процесс их ревью. В обоих случаях важна именно динамика и процентное соотношение причин дефектов. Разовые ошибки ничего не значат — важен тренд. Бэклог не исправленных дефектов и их возрастКаждый неисправленный внутренний дефект существует в проде. Если кастомеры еще не жалуются по этому поводу, это не значит, что дефект не нашли. Пользователи могут просто не тратить время на репорт мелких проблем. Им проще обойти баг, смириться с неудобством или вовсе отказаться от части функциональности. И тогда дефект не попадает в трекер, но продолжает влиять на пользовательский опыт, конверсию и лояльность. В результате забагованности системы может снизиться NPS. Количество критов/блокеров и возвратов на доработкуЕсли после разработки нового функционала и передачи в тестирование, тестер ловит крит или блокер, это означает, что разработчик не проверил то, что накодил. Такие ситуации напрямую увеличивают TTM и делают разработку дороже. Высокое количество возвратов — это сигнал не о проблемах QA, а о проблемах инженерной дисциплины внутри разработки. Вместо движения вперед команда начинает ходить по кругу: тестер проверяет, находит проблему, разработчик отвлекается от новых задач, возвращается в контекст, исправляет, снова отдает в тестирование — и цикл повторяется. Тут тоже важен тренд. Понятие “много” возвратов или нет — индивидуально для каждой команды. Шаблон аналитической постановкиЭто не метрика, а качественный показатель зрелости. Когда у команды есть единый шаблон, качество ТЗ можно системно улучшать. В него постепенно добавляются нужные разделы, уточняется уровень детализации, фиксируется формат описания сценариев, ограничений и пограничных случаев. Шаблон становится инструментом влияния на процесс, а значит — и на итоговое качество продукта. Если же постановка каждый раз разная и нет договоренности, что именно в ней должно быть, команда тратит огромное количество времени на уточнения. Разработчик спрашивает одно, тестировщик — другое, что-то проговаривается устно и теряется. Приходят новые люди — и начинают задавать те же вопросы. Через пару релизов уже невозможно восстановить, почему было принято то или иное решение. Покрытие unit-тестамиДолго сомневалась, включать ли эту метрику в обязательные. В итоге включаю — но с дисклеймером. Если вы стартап, делаете MVP, тестируете гипотезу и живете в режиме “сделать быстро”, требовать большого покрытия unit-тестами — странно. На этом этапе скорость может быть важнее инженерной зрелости. Но если продукт развивается системно, есть долгосрочная цель, команда не живет от релиза к релизу и существует договоренность о стандартах разработки — покрытие unit-тестами становится базовой инженерной метрикой. ИтогоНе существует универсального набора метрик, который гарантирует качество. Но есть один неизменный принцип: невозможно отвечать за то, что не измеряется и не анализируется. При этом важно не количество показателей, а системная работа: отслеживание динамики, понимание причин и готовность менять процессы. Отвечать за качество — значит видеть всю картину: от аналитики до продакшена. И принимать решения, которые делают эту систему устойчивее. Итоговый список отслеживаемых показателей: В рамках продукта
В рамках процесса
Качество тестирования
Метрики автоматизации
Качество аналитики и разработки
Что важно помнить: при постоянной работе с метриками, они имеют свойство стабилизироваться. И тогда нужно смещать фокус на другие зоны роста. Ответственность за качество — это тоже процесс, который можно и нужно постоянно улучшать. |